AnyShare-Ceph异常状态排查最佳实践
关键字
Ceph、异常排查
适用产品
- AnyShare 6.0.x
目的
对用户环境中可能出现的 Ceph 异常状态做一些分析和运维建议,以便售后人员能够更明确地了解 Ceph 集群运维的一些技巧。
解决方案
1.基本状态查询:
1.1 查看 Ceph 总体状态。下图示例中,显示有3个 mon 节点,但是 quorum 中只能看到2,1两个,很有可能 mon.0 所在的节点很有可能掉线了:
ceph -s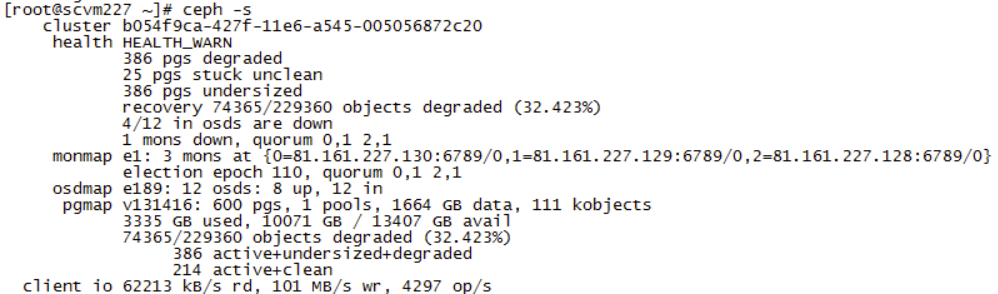
1.2 查看 osd 拓扑结构及状态。下图示例是 Ceph 集群 osd 拓扑结构及其状态的一个基本输出,osd 即为前端看到的虚拟磁盘。下图示例中显示主机226上的所有 osd 都掉线了。可能的原因是主机226未开机,或者主机226的磁盘连接设备出了问题。针对后者,进一步地可以在主机226上使用 mount 等命令检查磁盘挂载情况:
ceph osd tree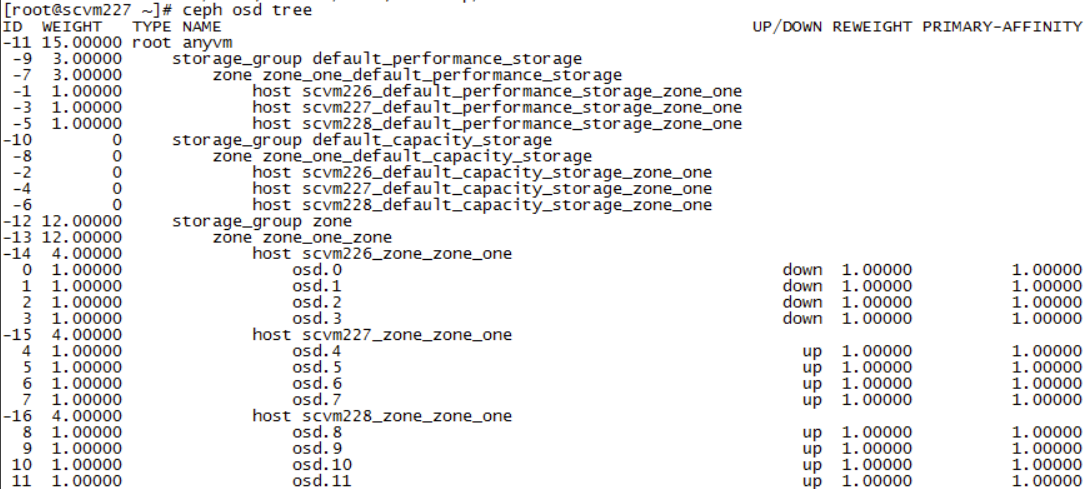
1.3 查看集群的健康状态的详细信息。具体地将指出哪些 pg 的状态异常,哪些 osd 上有慢 IO:
ceph health detail
1.4 查看 Ceph osd map 详细信息的输出。在 flags 这一行,我们可能设置一些标记来 noup 或者 noout 这样的标记来方便运维,当运维结束后,若标记残留,则可能导致 Ceph 集群无法正常工作。例如 noup 可能导致 osd 无法正常启动,而 noout 可能导致无法进行数据修复。另外 replicated size 表示正常副本数,min_size 表示最小副本数。如果最小副本数小于正常副本数的一半(向上取整),则说明这个池的副本数配置错误,有丢失数据的风险。:
ceph osd dump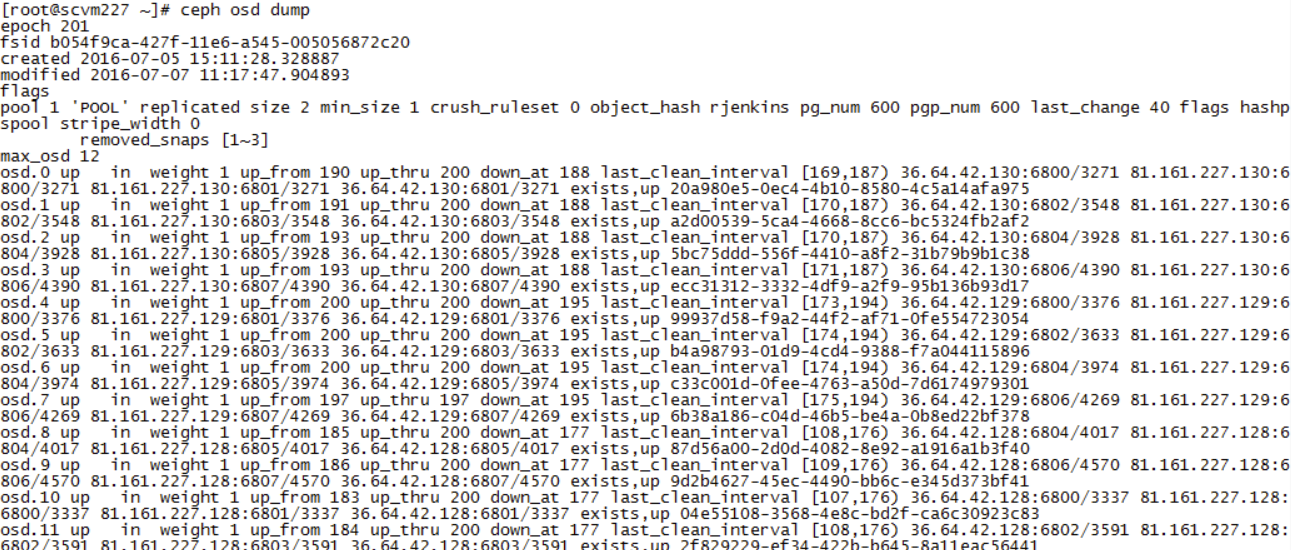
1.5 查看 osd.x 的基本状态,其中“state”一项必须为 "active" 时才算该 osd 正常工作:
ceph daemon osd.x status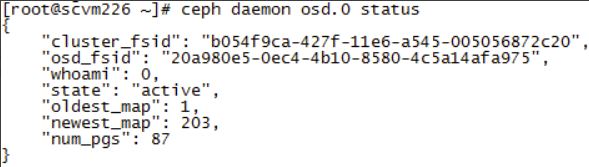
1.6 查看 osd.x 当前正在处理的 IO 操作,注意 "initiated_at","age","duration" 三项,慢 IO 的 age 和 duration 很高;type_data 项中标记个这些 IO 的操作流程,可以输出给研发人员进行分析。一般慢 IO 出现的原因可能(1)是 journal 数据写到HDD 较慢(2)被同步到其他 osd 的操作卡死(3)有数据对象的锁被占用(4)数据丢失……
ceph daemon osd.x ops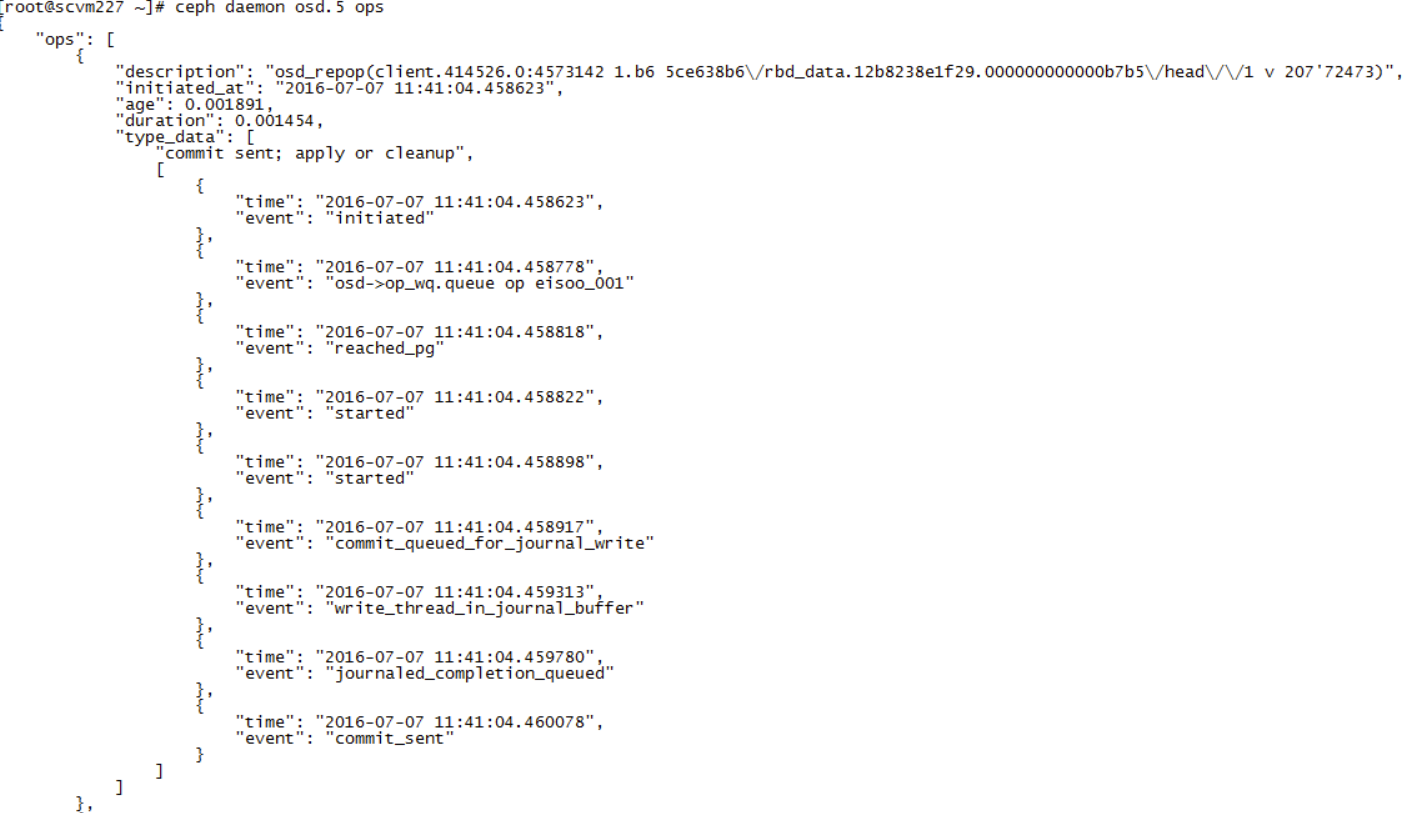
1.7 查看 osd.x 的基本状态,其中“state”一项必须为 "active" 时才算该 osd 正常工作:
ceph daemon osd.x status
2.1 在输入
ceph -s
ceph health detail
ceph osd tree
这三个命令以后,一般都能显示出 ceph 集群的基本异常问题。
2.2 慢 IO 问题
造成慢 IO 的原因很多,可以通过
ceph health detail
查找到是哪个 osd 上有慢 IO,使用
ceph daemon osd.x ops
可以确认哪个 IO 是慢 IO 。一般来说重启这个 osd 能够处理大多数的慢 IO 问题。
2.3 osd 翻转问题
在使用
ceph osd tree
命令查看,或者查看主 mon 的 log 时,发现有 osd 时而上线,时而下线,这种现象被称为 osd 翻转。造成 osd 翻转的直接原因是各个 osd 之间的心跳包无法正常收发,导致各个 osd 相互指责对方下线。下线的 osd 又重新 boot 上线,导致 osd 翻转。这时需要检查集群中的各个主机两两之间是否可以 ping 通,若有主机不能 ping 通,则重启这个主机。
2.4 pg stuck in peering
使用
ceph -s
ceph health detail
可以显示长时间处于 peering 状态的 pg。
对 stuck in peering 的 pg,使用
ceph pg pgid query
命令来查看 "blocked_by" 项,有哪些 osd 阻塞了 peering,重启造成阻塞的 osd。
2.5 pg incomplete
使用
ceph -s
ceph health detail
可以显示哪些 pg 处于 incomplete 状态。这一般是由于节点剧烈上下线的抖动,以及节点缺失造成的。
2.6 pg unfound
使用
ceph -s
ceph health detail
可以显示哪些 pg 处于 unfound 状态(这个pg的某些objects数据丢失!!!)。开启所有 osd,将之前从集群中删除的主机重新添加到集群中来。如果仍然有 unfound,可以使用
ceph pg pgid mark_unfound_lost revert
命令将丢失的数据恢复成它上一个版本(即遗弃它最近的一次写入)。这个操作只能针对非关键的数据使用!!!即对这些数据而言,恢复服务状态更重要(unfound 会造成慢IO)。
2.7 scrub error
对有 scrub error 的 pg,可以使用以下命令将其修复:
ceph pg repair pgid
2.8 deep scrub 影响 IO
在某些时候,高 iops 场景下,deep scrub 由于达到 deadline 而启动,可能造成前端 IO 高延迟导致业务中断。可以通过以下命令来停止 deep scrub:
ceph osd set nodeep-scrub
这设置了 nodeep scrub 状态。这个状态的 ceph 集群是不稳定的,所以在高 IO 时间获取以后,应该清除 nodeep scrub 状态:
ceph osd unset nodeep-scrub
更多信息
同时停掉位于不同主机的两个 osd 的做法,都是极其危险的,将导致无法给前端业务提供服务,也可能导致数据丢失。修改系统时间的操作,可能导致 osd 不能正常工作。因此在启动 ceph 服务之前,要确保 ntp 服务已经生效。